
NVIDIA dévoile aujourd’hui Nemotron 3.5 Super VL, un modèle ouvert de 120 milliards de paramètres qui offre l’exécution des tâches la plus rapide et la meilleure précision pour les agents spécialisés fonctionnant en continu.
Il est accompagné de deux nouveaux modèles pour l’edge : Nemotron 3.5 Bolt 74B-A9B 24GB, optimisé pour équilibrer intelligence et vitesse par Go pour les charges de travail agentiques locales, et Nemotron 3.5 Bolt E4B 4GB, optimisé pour l’intelligence par Go au service d’agents conversationnels rapides.
Super VL et Bolt 74B-A9B sont disponibles dès maintenant, et Bolt E4B le sera à partir du 23 octobre.
Ensemble, ces trois modèles ouverts couvrent l’intégralité du spectre de déploiements des agents, des grands serveurs d’entreprise jusqu’aux appareils edge et aux équipements locaux.
Toute organisation souhaitant exécuter des agents sur une infrastructure NVIDIA dispose désormais d’un modèle ouvert et optimisé adapté à son niveau, sans devoir choisir entre capacités et facilité de déploiement.
Super VL et Bolt rejoignent la famille Nemotron aux côtés de Lightning et Ultra.
Lightning, dévoiléen août, gère les charges de travail à haut débit ; Ultra traite les tâches de raisonnement les plus complexes ; et Bolt apporte l’intelligence à l’edge.
Nemotron 3.5 Super VL : une précision de pointe pour un cinquième de la taille
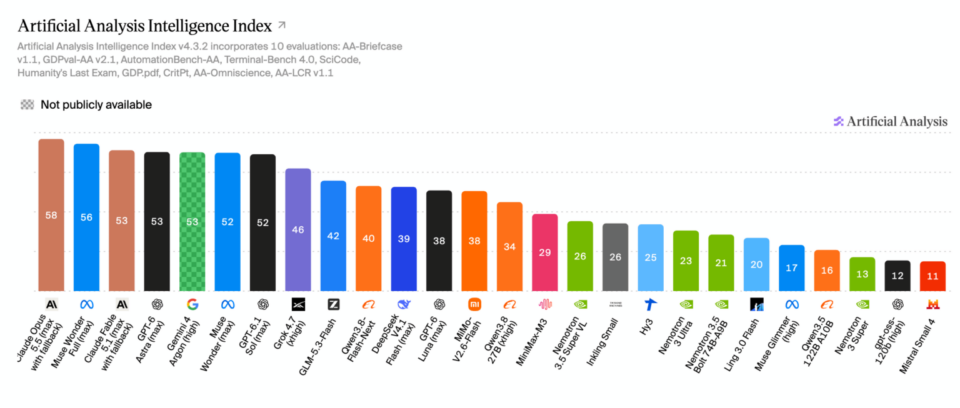
Développé en collaboration avec la Nemotron Coalition, Super VL offre une précision de premier plan sur les tâches agentiques multimodales (suivi d’instructions, utilisation d’outils, workflows métier en plusieurs étapes et compréhension visuelle), comparable à celle du plus grand modèle de raisonnement de NVIDIA, pourenviron un cinquième du nombre de paramètres.
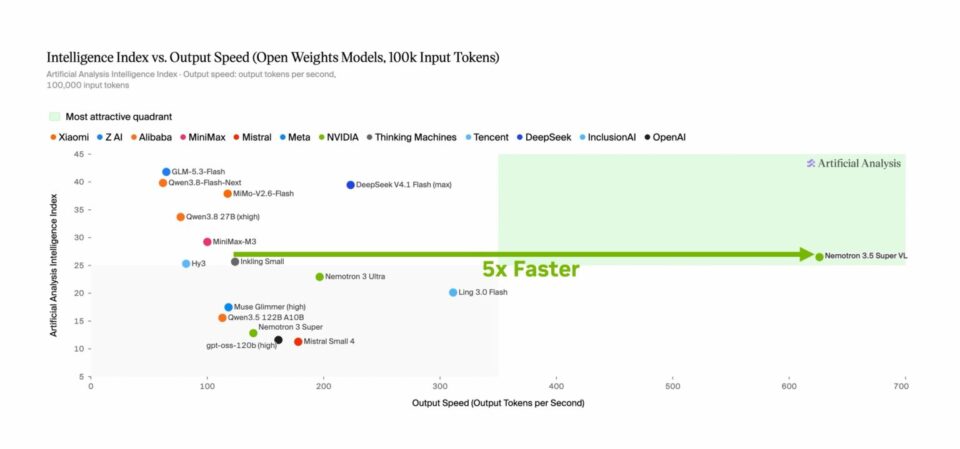
En tant que modèle agentique ouvert le plus rapide de sa catégorie, 5x plus rapide que le suivant, il permet aux agents d’entreprise d’accomplir plus rapidement des tâches à fortvolume dans des workflows qui s’étendent sur plusieurs jours, voire dessemaines.
Contrairement aux modèles fermés de pointe, Super VL peut être post-entraîné par les organisations sur leurs propres données, déployé sur leur propre infrastructure, tout en gardant le contrôle de ce qu’elles développent.
Nemotron 3.5 Bolt : l’intelligence agentique à l’edge
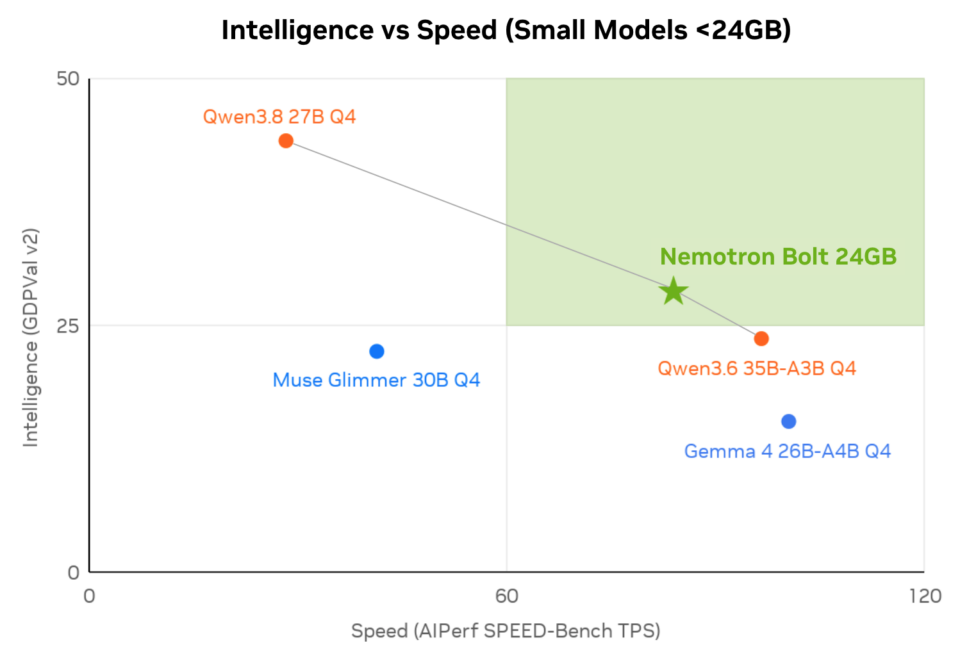
Bolt 74B-A9B 24GB est conçu pour exécuter localement les tâches agentiques du quotidien sur NVIDIA RTX/DGX Spark, grâce à une quantification native sur 2 bits qui lui permet de tenir dans 24 Go de mémoire et de fonctionner en parallèle d’autres applications.
Par rapport aux autres modèles à l’empreinte mémoire similaire, il offre un bon équilibre entre intelligence et vitesse : suffisamment intelligent pour mener à bien la plupart des tâches, tout en étant bien plus rapide que les modèles les plus intelligents.
Avec Bolt 74B-A9B 24GB, les utilisateurs peuvent déléguerleurs projets à des environnements d’agents locaux répandus, de la recherche sur le web à la rédaction en passant par le débogage de code, sans envoyer ces charges de travail vers le cloud. Il s’agit du modèle ouvert n° 1 de sa catégorie sur PinchBench et du modèle ouvert n° 2 sur BrowseComp.
Bolt E4B 4GB est conçu pour les agents physiques et conversationnels sur GeForce RTX, Jetson et RTX/DGX Spark. Il associe une conversation naturelle à des capacités agentiques multitours pour alimenter des assistants vocaux locaux rapides, des personnages interactifs et des interfaces embarquées.
L’adoption d’une super-intelligence personnalisée
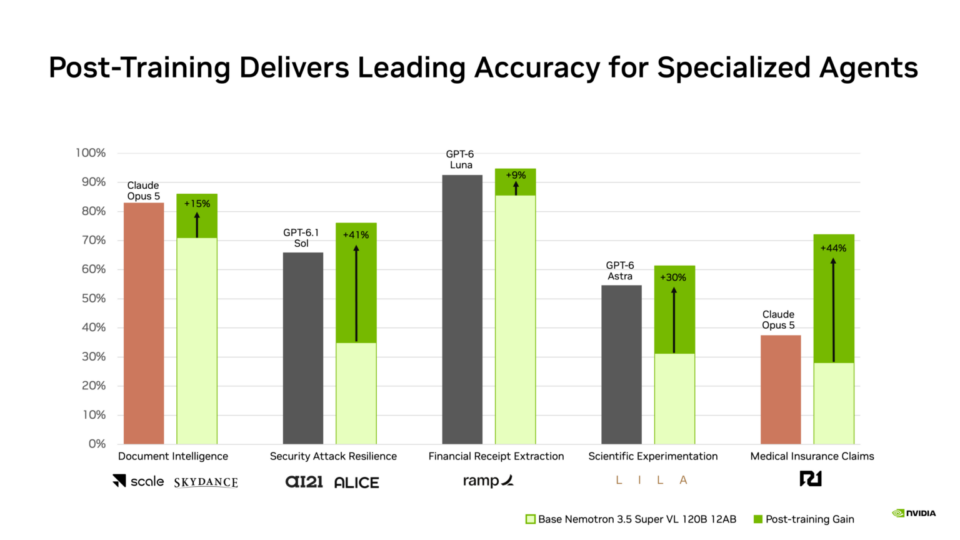
Des dizaines d’organisations de tous secteurs post-entraînent Super VL sur leurs propres données, outils, politiques et workflows afin d’améliorer la précision sur les tâches spécialisées qui caractérisent leurs déploiements d’agents.
Super VL fait l’objet d’un post-entraînement et d’une personnalisation par des organisations de tous secteurs. Scale AI a post-entraîné le modèle pour l’agent de financement du crédit fournisseurs de Skydance et pour l’agent de due diligence en matière de fusions-acquisitions d’EY. AfterQuery a personnalisé le modèle pour Hebbia afin d’analyser des contrats de crédit. AI21 et Alice ont post-entraîné le modèle pour la résilience face aux cyberattaques. Mercor a post-entraîné le modèle sur le benchmark de codage APEX-SWE, pour des agents de codage capables de planifier, d’écrire et de déboguer du code. ModelScope permet aux développeurs d’affiner le modèle via son framework ms-swift pour des applications multimodales spécialisées.
Parmi les autres organisations qui personnalisent Nemotron 3.5 Super VL figurent Ramp, pour l’intelligence documentaire financière ; Dream, pour la recherche en cybersécurité et l’analyse des vulnérabilités reposant sur une IA souveraine ; Lila Sciences, pour la découverte et la recherche scientifiques ; et R1, pour l’analyse des demandes de remboursement médicales et la gestion du cycle de revenus. TrainLoop a post-entraîné le modèle avec des données de dermatologie de Nolla, qui vient de devenir la première entreprise autorisée à utiliser l’IA pour rédiger les prescriptions initiales des patients.
Les éditeurs de plateformes logicielles qui intègrent Nemotron 3.5 Super VL incluent :
- Atlassian, pour des tâches telles que la recherche agentique dans des applications comme Jira et Confluence.
- CrowdStrike, qui personnalise le modèle pour des opérations de blue team agentiques dans la sécurité des entreprises.
- Dassault Systèmes, pour la conception d’ingénierie et la simulation.
- Perplexity, pour la recherche et les tâches agentiques dans Perplexity Search et Computer.
- Salesforce, qui personnalise Nemotron pour alimenter des agents d’IA qui numérisent et automatisent des workflows gouvernementaux complexes dans des environnements clients sécurisés, via Missionforce Operations.
- Le logiciel de Synopsys destiné à la vérification de la conception de semi-conducteurs est interopérable avec le modèle.
Ce que Nemotron 3.5 Super VL perçoit réellement
Les points forts de Nemotron 3.5 Super VL en matière de vision et de langage ciblent ce que les agents rencontrent en pratique : la reconnaissance optique de caractères, les tableaux, les graphiques et les informations structurées des documents visuels.
Il traite une page web, en extrait le texte, lit les graphiques et diagrammes, puis restitue des informations à partir de ce qu’il trouve. Il en va de même pour les PDF et les autres documents que les agents traitent couramment.
Nemotron 3.5 Super VL comprend les images, les pages web et les PDF, et agit en fonction de cette compréhension. Réunir la compréhension du texte et celle des éléments visuels dans un seul modèle évite aux agents de répartir les tâches entre des systèmes distincts : le contexte se maintient tout au long du processus, du document aux données jusqu’à la décision.
Un modèle ouvert pour un contrôle, une sécurité et une confidentialité maximaux
L’ouverture et la personnalisation se renforcent mutuellement. Le modèle est fourni avec des poids ouverts, des jeux de données ouverts et des recettes d’entraînement.
Le contrôle s’exerce dans deux directions. Les organisations peuvent exécuter le modèle partout où leurs exigences en matière de sécurité et de résidence des données l’imposent. Elles choisissent également d’adopter un modèle qu’elles peuvent adapter, plutôt qu’un modèle soumis aux restrictions d’un fournisseur.
Dans le secteur des assurances, par exemple, un agent personnalisé peut analyser de façon répétée les déclarations de sinistre pour détecter des indicateursde fraude. Dans les services financiers, un agent peut examiner les scores de crédit et signaler les activités qui ne correspondent pas aux critères de prêt propres à l’organisation. Le modèle reste sur site. Les données restent privées.
La personnalisation est prise en charge par NVIDIA NeMo, des pipelines basés sur Python et des jeux de données ouverts.
Nemotron 3.5 Super VL a été entraîné sur environ 26 000 milliards de tokens lors du pré-entraînement et du pré-entraînement continu, puis post-entraîné avec environ 3,8 millions d’échantillons et de l’apprentissage par renforcement dans des dizaines d’environnements.
NVIDIA publie également sur Hugging Face des jeux de données ouverts couvrant l’utilisation agentique d’outils, la finance, le suivi d’instructions, le contexte long, l’équité et la compréhension vision-langage, ainsi que les environnements d’apprentissage par renforcement dans NeMo Gym.
NVIDIA NIM fournit le modèle sous forme de microservice prêt pour la production, avec des configurations validées et optimisées en termes de performances ainsi qu’un support de niveau entreprise, mis à jour toutes les deux semaines avec des correctifs de sécurité et des améliorations de performances.
En outre, exécuté sur NVIDIA Dynamo, le modèle permet aux organisations deservir jusqu’à 8x plus d’utilisateurs avec une latence réduite de 85 %.
Nemotron 3.5 Super VL est disponible dès maintenant sur Hugging Face, Open Router, la communauté ModelScope et sous forme de NVIDIA NIM.
Fonctionne sur DGX Spark, DGX Station et RTX
Nemotron 3.5 Super VL fonctionne sur l’ensemble de la gammematérielle de NVIDIA : sur les systèmes DGX Spark, DGX Station, RTX PRO et RTX pour une intelligence locale sur le poste de travail, sur NVIDIA Jetson à l’edge, ainsi que dans les environnements de centre de données et de cloud.
Nemotron 3.5 Bolt 74B-A9B 24GB est disponible dès maintenant sur Hugging Face, avec la prise en charge de llama.cpp, Ollama, LM Studio, Unsloth et vLLM. Conçu pour les ordinateurs portables NVIDIA RTX Spark disponibles à partir du 16 octobre, il fonctionne également sur les PC GeForce RTX, DGX Spark, DGX Station et les stations de travail RTX PRO.
Téléchargez les poids ouverts, explorezles ressources de personnalisation avec NVIDIA NeMo ou consultezle blog technique pour une présentation complète de l’architecture.
Restez informé de l’actualité des agents, de NVIDIA Nemotron et bien plus encore en vous abonnant aux actualités de NVIDIA, en rejoignant la communauté et en suivant NVIDIA AI sur LinkedIn, Instagram, X et Facebook.
Explorezes tutoriels vidéo à suivre à votre rythme et des diffusions en direct.
Consultez l’avis concernant les informations sur les produits logiciels.