
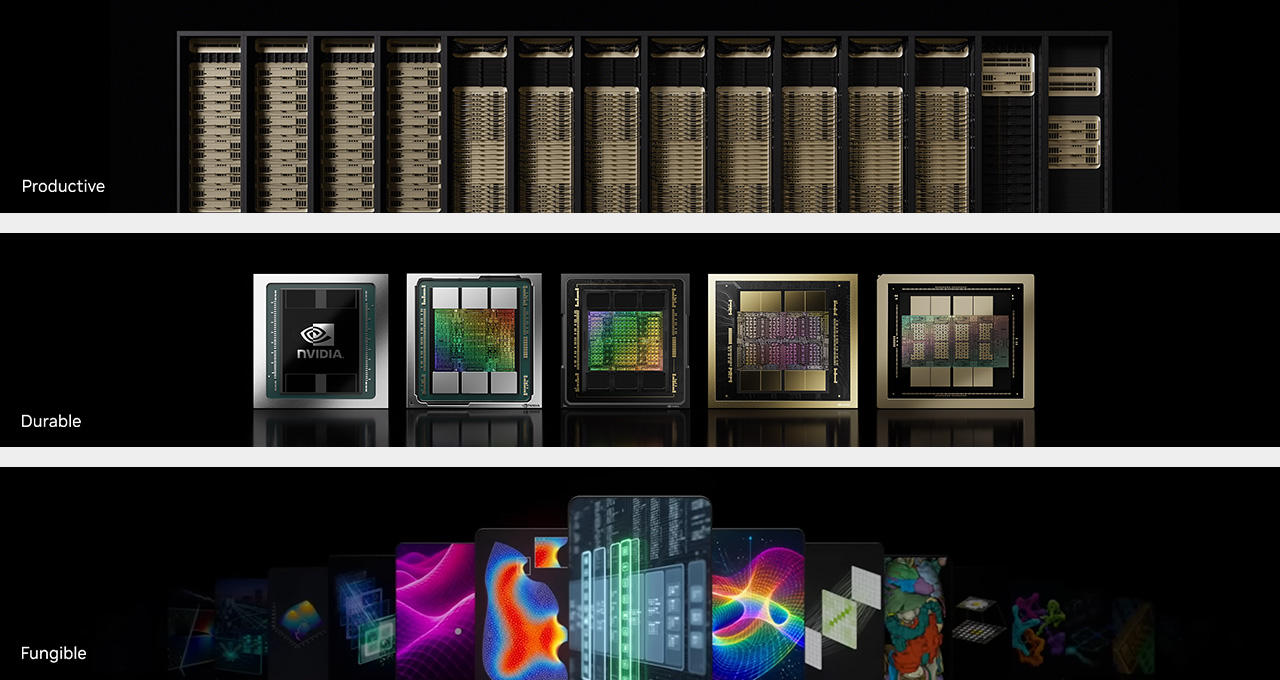
Les usines d’IA se construisent au mégawatt, voire au gigawatt. Chaque mégawatt d’usine coûte environ 60 millions de dollars, et les exploitants d’usines d’IA n’engagent des capitaux d’une telle ampleur qu’avec une vision claire du retour sur investissement. Trois facteurs clés déterminent la rentabilité des usines d’IA :
- Capacité de revenus : Ce que l’usine pourrait générer en un an si elle vendait chaque token qu’elle est en mesure de produire.
- Durée de vie utile: La durée pendant laquelle son matériel d’IA continue de générer des revenus.
- Demande: Le niveau de demande pour ces tokens.
La force de l’un de ces facteurs ne peut pas compenser entièrement la faiblesse d’un autre. Une capacité de revenus élevée compte peu si l’usine ne vend qu’une partie de ce qu’elle peut produire. Une forte demande importe peu si l’usine cesse de produire à pleine capacité au bout d’un an seulement. Ces trois facteurs ne sont pas non plus indépendants. Une usine capable d’exécuter davantage de types de charges de travail trouve davantage de demande, ce qui lui permet de continuer à générer des revenus année après année.
Les usines d’IA NVIDIA sont conçues pour optimiser ces trois facteurs. Elles sont :
- Productives: Elles offrent le débit par mégawatt le plus élevé et le coût par token le plus bas, ce qui maximise leur capacité de revenus.
- Durables: Les GPU et systèmes NVIDIA continuent de générer des revenus des années après leur commercialisation, prolongeant ainsi leur durée de vie utile.
- Fongibles: Elles exécutent tous les types d’IA, à chaque phase et en tout lieu, ainsi que de nombreuses charges de travail qui ne relèvent pas du tout de l’IA, ce qui approfondit et élargit la demande à laquelle elles peuvent répondre.
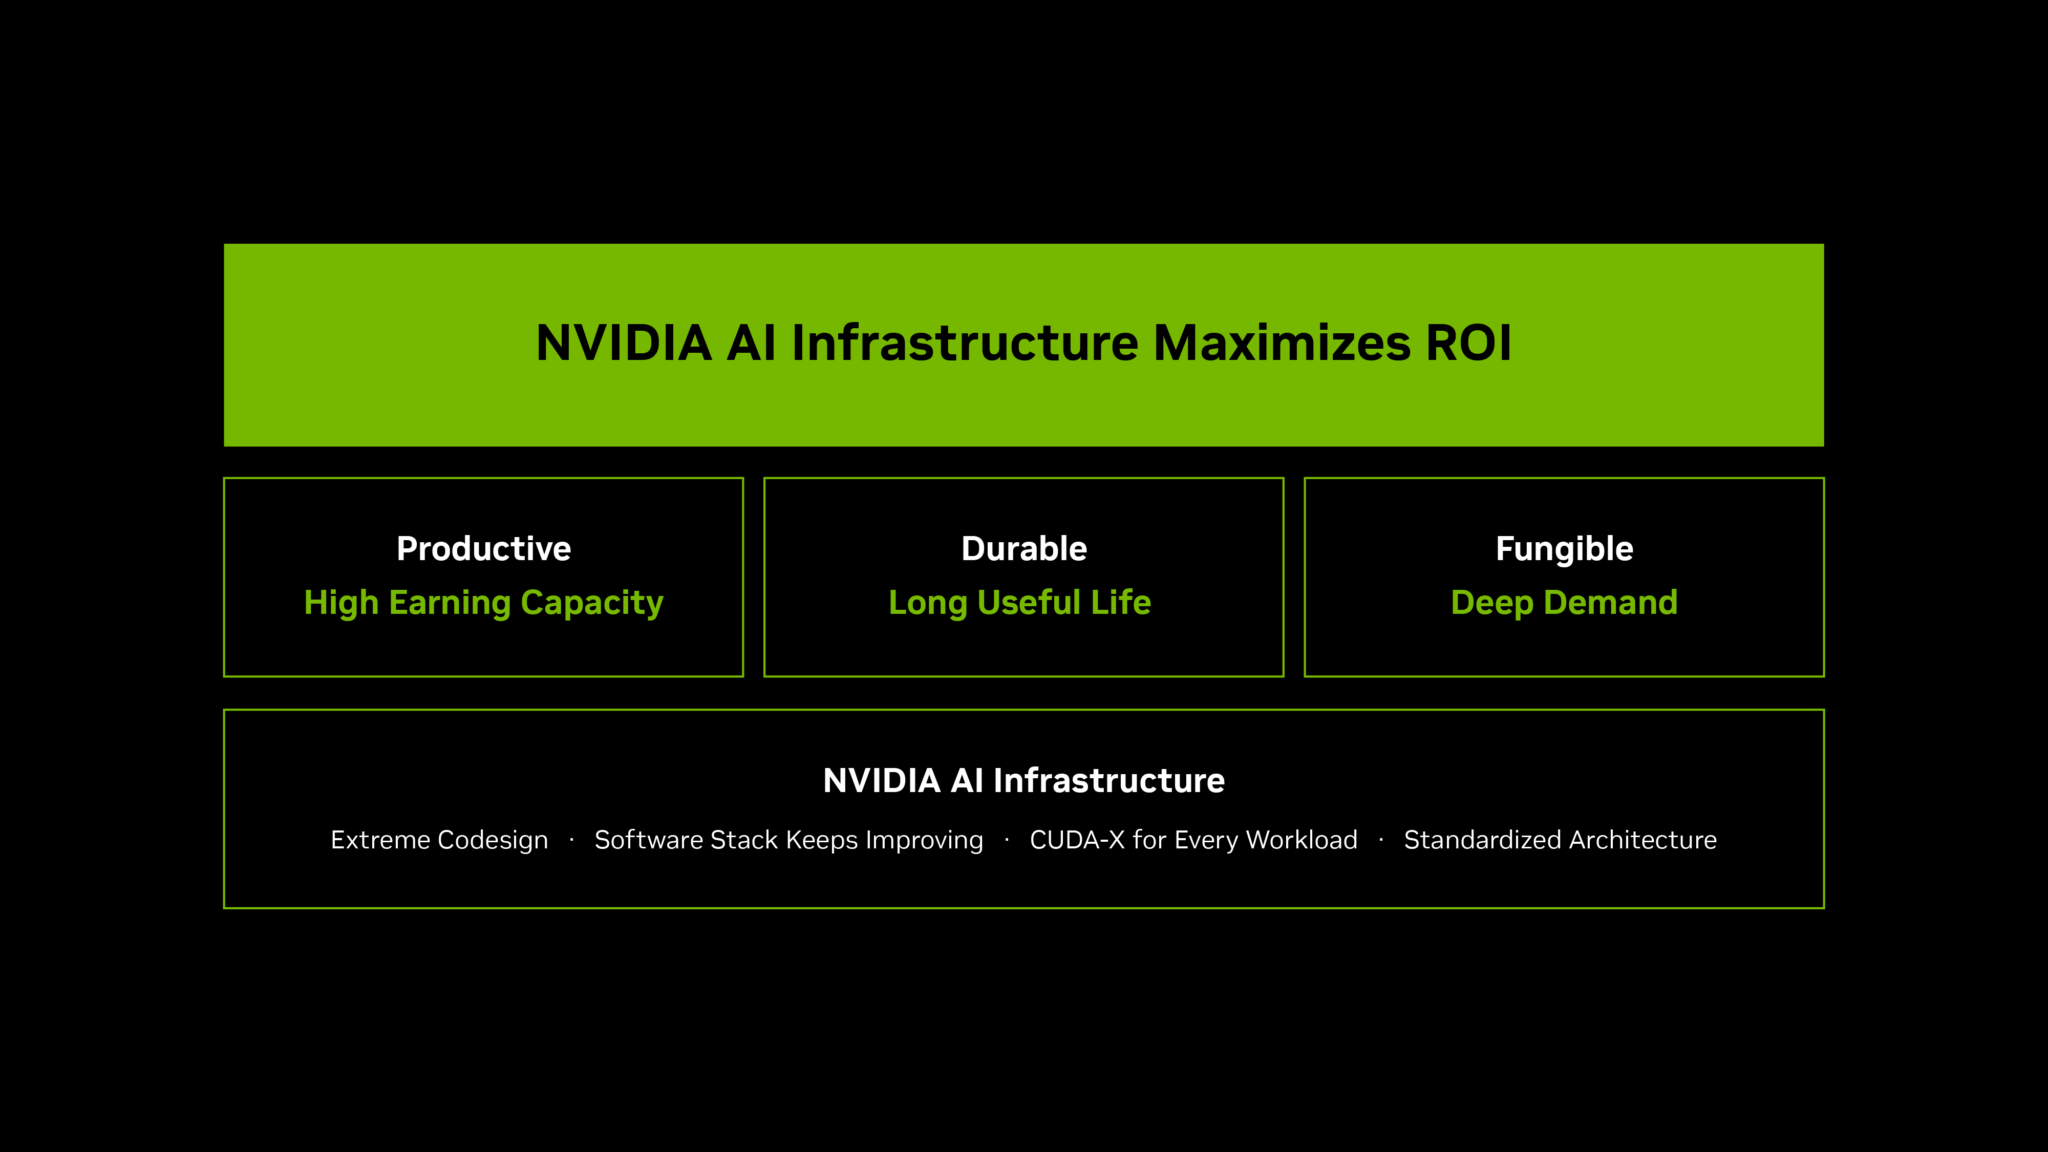
La co-conception technique sur l’ensemble de la pile maximise le débit des usines d’IA, et l’optimisation logicielle continue maintient la productivité du matériel installé des années après sa commercialisation. Les librairies NVIDIA CUDA-X permettent à une usine d’exécuter toute charge de travail accélérée. Une architecture standardisée met ensuite l’ensemble de ces capacités à la portée de tout opérateur, avec un déploiement à partir d’une conception de référence validée.
Productivité : le plus grand nombre de tokens par mégawatt et le coût par token le plus bas
L’énergie constitue la contrainte déterminante d’une usine d’IA. Le nombre de tokens par seconde et par mégawatt devient ainsi l’indicateur qui détermine la capacité de génération de revenus. Davantage de tokens dans une enveloppe énergétique fixe se traduit par davantage de revenus. Un coût par token plus faible se traduit par une marge plus élevée sur chaque token.
SemiAnalysis AgentX indique que les systèmes NVIDIA Vera Rubin NVL72 offrent un débit par mégawatt plus de 30 fois supérieur à celui des systèmes NVIDIA GB300 NVL72, ainsi qu’un coût par million de tokens jusqu’à 45 fois inférieur sur le modèle DeepSeek V4 Pro. Des gains d’une telle ampleur résultent d’une co-conception extrême sur l’ensemble de la pile : des modèles et des charges de travail jusqu’aux logiciels, au calcul, au réseau et à la mémoire, le tout optimisé de manière conjointe.
Deux questions se posent alors. Si chaque génération rend les tokens considérablement moins coûteux, la demande en calcul diminue-t-elle?
Non, elle augmente.
Des tokens moins coûteux rendent davantage de cas d’usage économiquement viables, et ces cas d’usage consomment plus de tokens que ce que les gains d’efficacité ont permis d’économiser.
La seconde question porte sur la durabilité. Si chaque génération est nettement supérieure à la précédente, qu’advient-il des générations antérieures ?
Durabilité : la base installée continue de générer des revenus
Toutes les charges de travail ne nécessitent pas le système le plus récent. Le choix approprié dépend de la complexité et du profil de chaque charge de travail, ce qui explique pourquoi la génération précédente continue de générer des revenus après l’arrivée de la suivante.
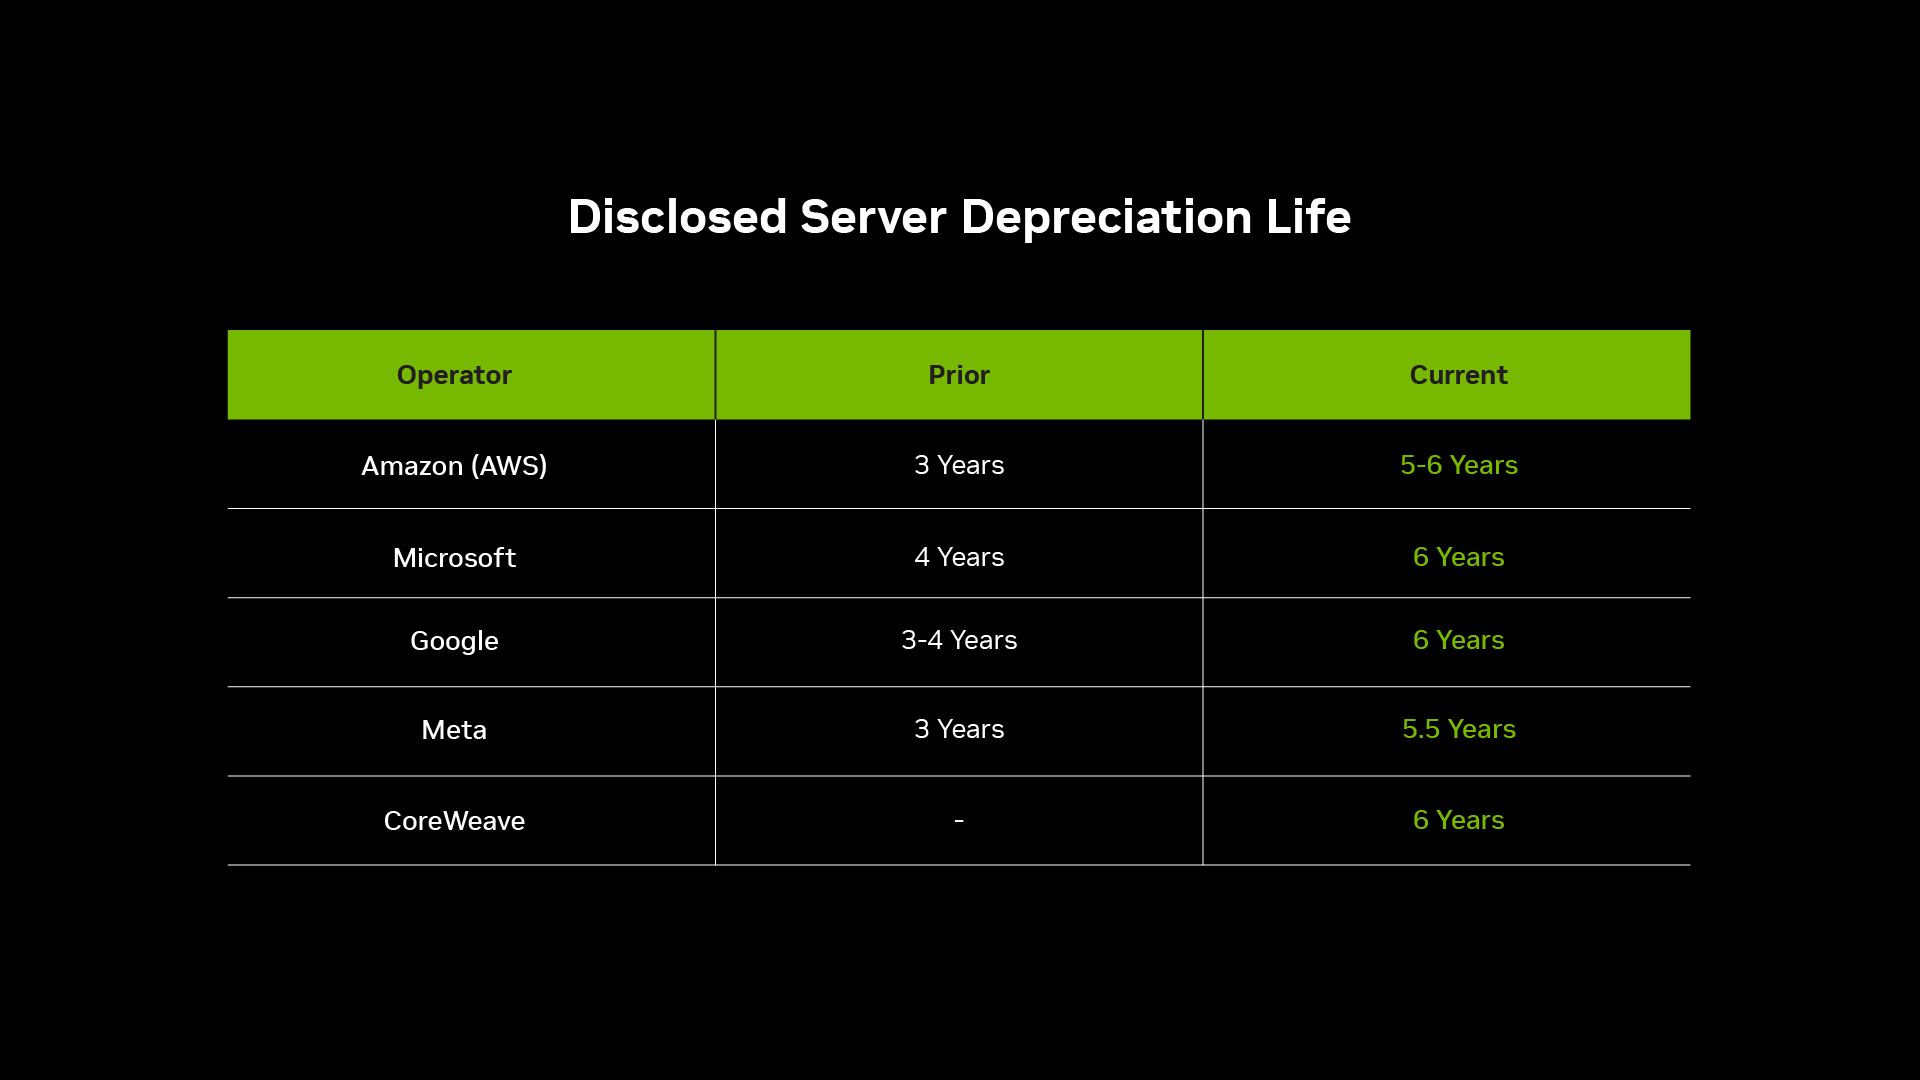
Le GPU NVIDIA A100, commercialisé en 2020, est toujours en service commercial six ans plus tard, ce qui témoigne de sa valeur économique durable ; CoreWeave a récemment prolongé jusqu’en 2029 les réservations d’unités introduites pour la première fois en 2020. Au fil des années, chaque grand opérateur a allongé la durée d’amortissement de ses serveurs. Cette durée constitue une estimation du moment où le matériel cesse d’être rentable, et cette estimation ne cesse d’être repoussée. Une analyse de Sprout publiée en septembre 2026, intitulée «The Productive Life of a Data Center GPU», retrace l’évolution de cette durée chez chacun des grands opérateurs.
Barkr estime la durée de vie utile à cinq à six ans pour un système H100 à huit GPU et à neuf à dix ans pour le GB300 NVL72, en se fondant sur les prix de revente de ces systèmes. Silicon Data montre qu’un GPU A100 de six ans conserve encore un quart de sa valeur d’achat, alors qu’un calendrier d’amortissement sur cinq ans ramenait sa valeur à zéro il y a déjà plus d’un an. Ornn Data constate que le marché paie, pour louer un GPU A100 dans le cadre d’un contrat de cinq ans, 80 % du prix pratiqué pour un contrat d’un mois.
CUDA, la plateforme logicielle qui permet de programmer les GPU NVIDIA, fonctionne d’une génération à l’autre ; ainsi, aucun équipement déjà détenu par un opérateur ne devient obsolète à l’arrivée d’une nouvelle architecture. L’optimisation continue des logiciels et des noyaux améliore constamment les capacités du matériel existant.
La même plateforme exécute l’apprentissage automatique, l’apprentissage profond, l’IA générative, le raisonnement, l’IA agentique et l’IA physique. Chaque nouveau type de charge de travail est arrivé sur un matériel déjà installé.
C’est cela, la fongibilité. Plus un système peut prendre en charge de types de charges de travail, plus il continue longtemps à trouver des tâches à exécuter.
Fongible : tous les types d’IA, toutes les phases, tous les environnements
Une usine conçue pour un seul type de travail repose sur le pari que ce travail perdurera. Une usine capable de tout exécuter reste utile et génératrice de revenus, même lorsque la nature du travail évolue.
Les usines d’IA NVIDIA exécutent tous les types de modèles d’IA, ouverts comme propriétaires, dans les domaines du langage, de la vision, de la biologie, de la physique et de la robotique. Elles couvrent toutes les phases, du traitement des données au pré-entraînement, en passant par le post-entraînement et l’inférence. Elles fonctionnent également dans tous les environnements, des clouds hyperscale et des clouds d’IA aux programmes souverains, en passant par les centres de données d’entreprise et la périphérie du réseau.
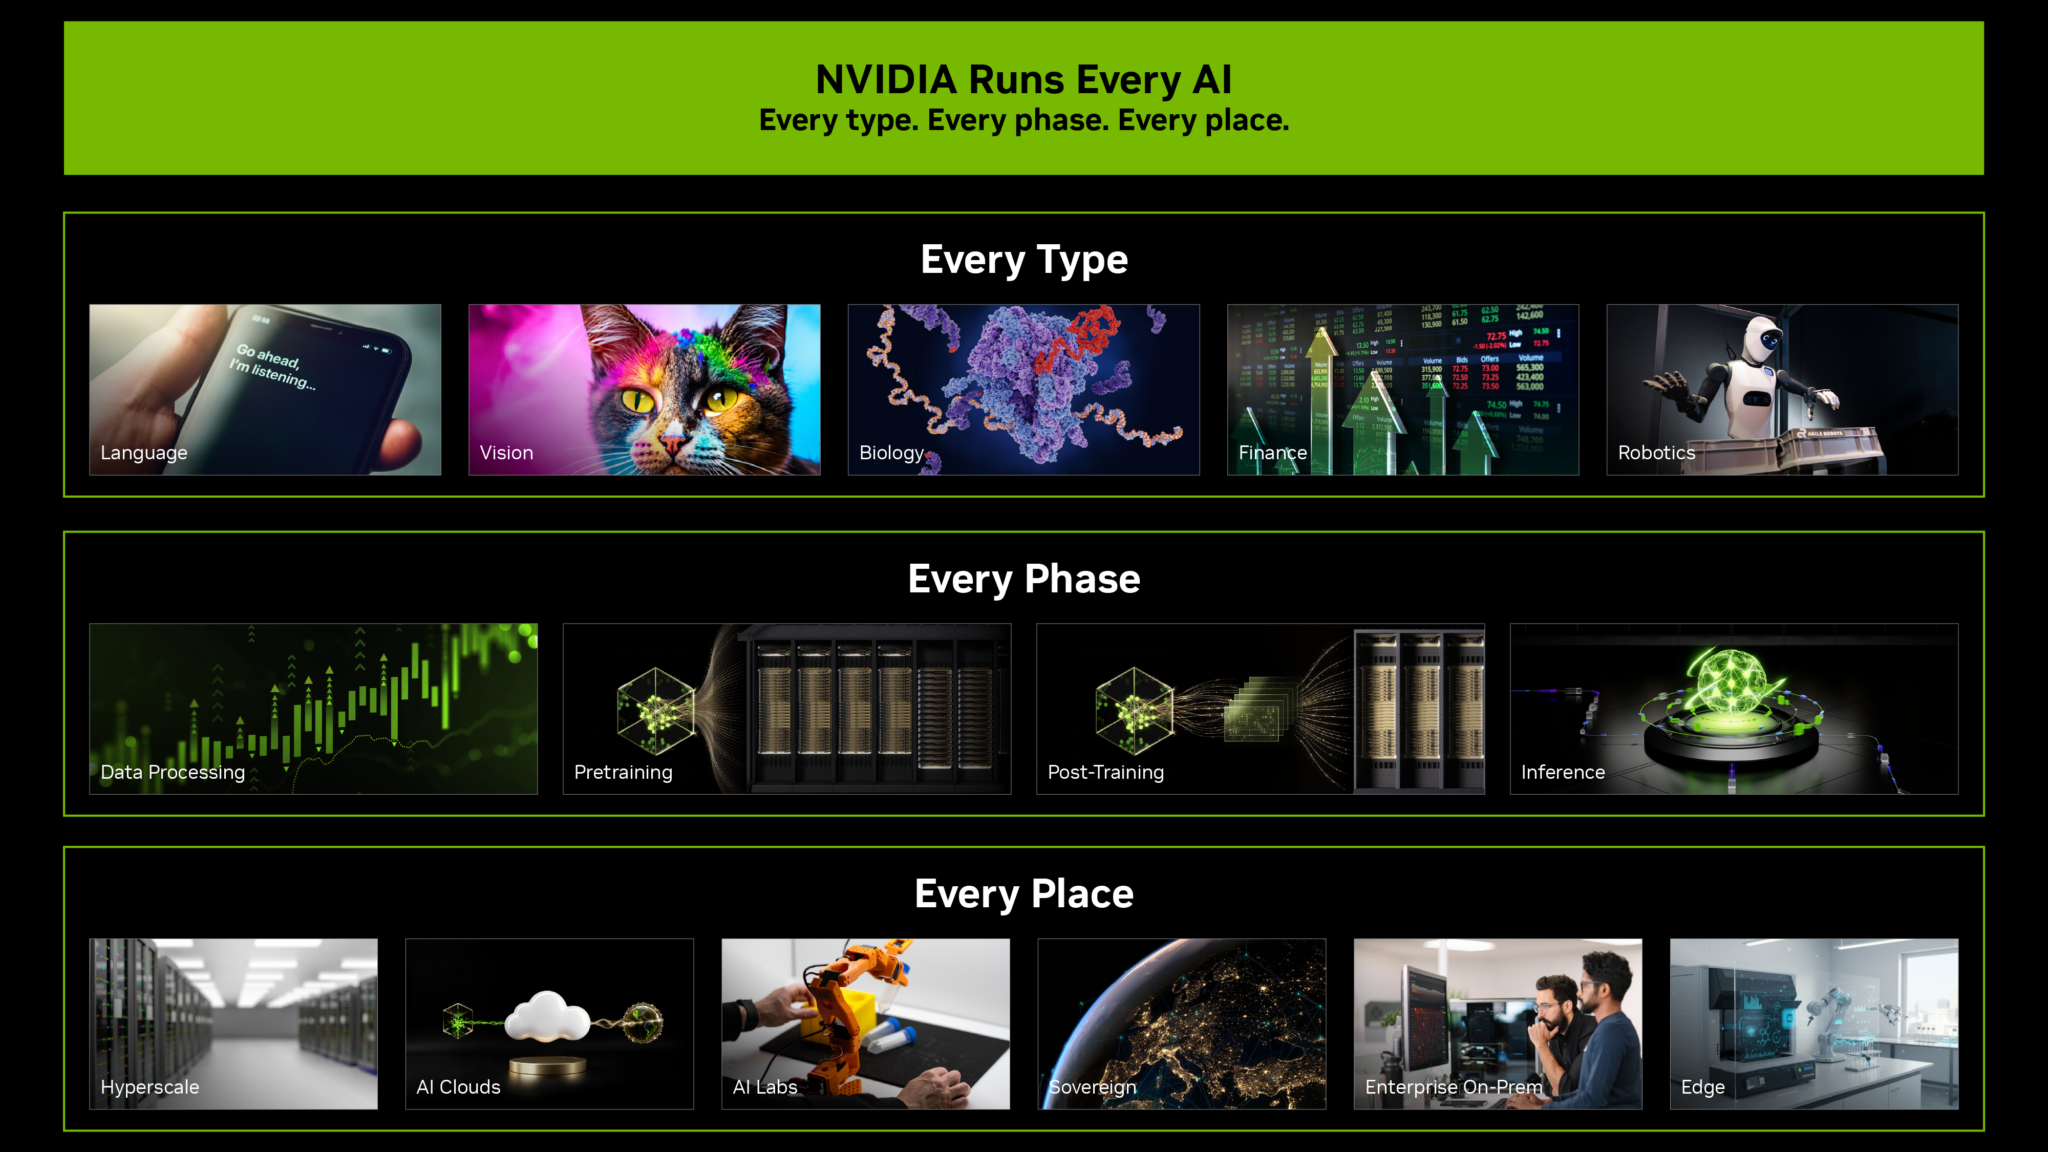
Ces charges de travail ne consistent pas toutes à concevoir et à exécuter des modèles d’IA. La même infrastructure prend également en charge le traitement des données, le calcul scientifique, la simulation, le graphisme, entre autres.
Toutes ces charges de travail, qu’elles relèvent ou non de l’IA, se ramènent aux mêmes calculs parallèles, et les GPU NVIDIA sont conçus précisément pour les exécuter simultanément sur des milliers de cœurs. CUDA est la raison pour laquelle une même puce peut simuler la lumière, replier une protéine et prédire le token suivant. Plus de 1 000 bibliothèques CUDA-X prêtes à l’emploi s’appuient sur cette base. Elles couvrent des domaines allant des réseaux de neurones profonds, de la lithographie computationnelle et de la simulation de circuits quantiques jusqu’à la recherche vectorielle et à la modélisation climatique, et plus de 10 millions de développeurs les utilisent.
C’est ce qui fait des GPU NVIDIA une solution de calcul accéléré polyvalente, plutôt qu’un ASIC personnalisé conçu pour une seule charge de travail. Être polyvalent ne signifie pas être générique : les cœurs Tensor et le Transformer Engine intègrent du matériel optimisé pour l’IA au sein d’une architecture programmable, ce qui réunit spécialisation et flexibilité sur une seule puce. C’est le fait qu’une seule architecture exécute l’ensemble de ces tâches qui permet de maintenir un taux d’utilisation élevé, et avec lui, le retour sur investissement.
Cette polyvalence se manifeste en production chez de nombreux clients :
- Lilly: Développement et exécution de modèles de protéines, de petites molécules et de génomique sur un cluster sur site de 1 016 GPU, ainsi que de chatbots et de workflows agentiques pour ses propres équipes.
- Pinterest: Post-entraînement et déploiement d’un modèle vision-langage sur un cloud hyperscale, sur 14 000 GPU couvrant les architectures NVIDIA Blackwell, Hopper et antérieures.
- Revolut: Traitement des données de milliards d’enregistrements de transactions avec NVIDIA cuDF, puis entraînement et déploiement d’un modèle de fondation sur un cloud d’IA.
- Runway: Entraînement d’un modèle de monde sur NVIDIA Hopper et déploiement en production sur la plateforme NVIDIA Blackwell à l’aide d’une infrastructure cloud.
- Texas A&M University: Exécution de simulations moléculaires et de travaux de découverte de médicaments par IA sur son supercalculateur, avec un taux d’utilisation de 95 à 98 % sur 26 projets et sept établissements.
Il en va de même au-delà de l’IA. Cosm exploite un data center distribué reposant sur NVIDIA, qui fournit des ressources de calcul flexibles pour la lecture vidéo haute résolution, le streaming, les graphismes en temps réel et l’affichage synchronisé. Dassault Systèmes alimente la simulation de jumeaux virtuels qui sous-tend la certification d’aéronefs à Wichita State et la conception de véhicules chez Lucid Motors. Et Unilever crée des visuels de produits à partir de jumeaux numériques plutôt que de séances photo, ce qui réduit de moitié les coûts de production.
Aucune liste d’exemples ne saurait être exhaustive ici, et c’est précisément le propos.
Les usines d’IA NVIDIA sont conçues pour être productives, durables et fongibles : des tokens plus rentables, une durée de vie utile plus longue et une demande plus soutenue. C’est ce qui maximise leur rendement.
Pour en savoir plus sur les usines d’IA NVIDIA, suivez la keynote de la GTC Berlin de Jensen Huang, fondateur et CEO de NVIDIA, le mercredi 21 octobre à 11 h (CEST).