
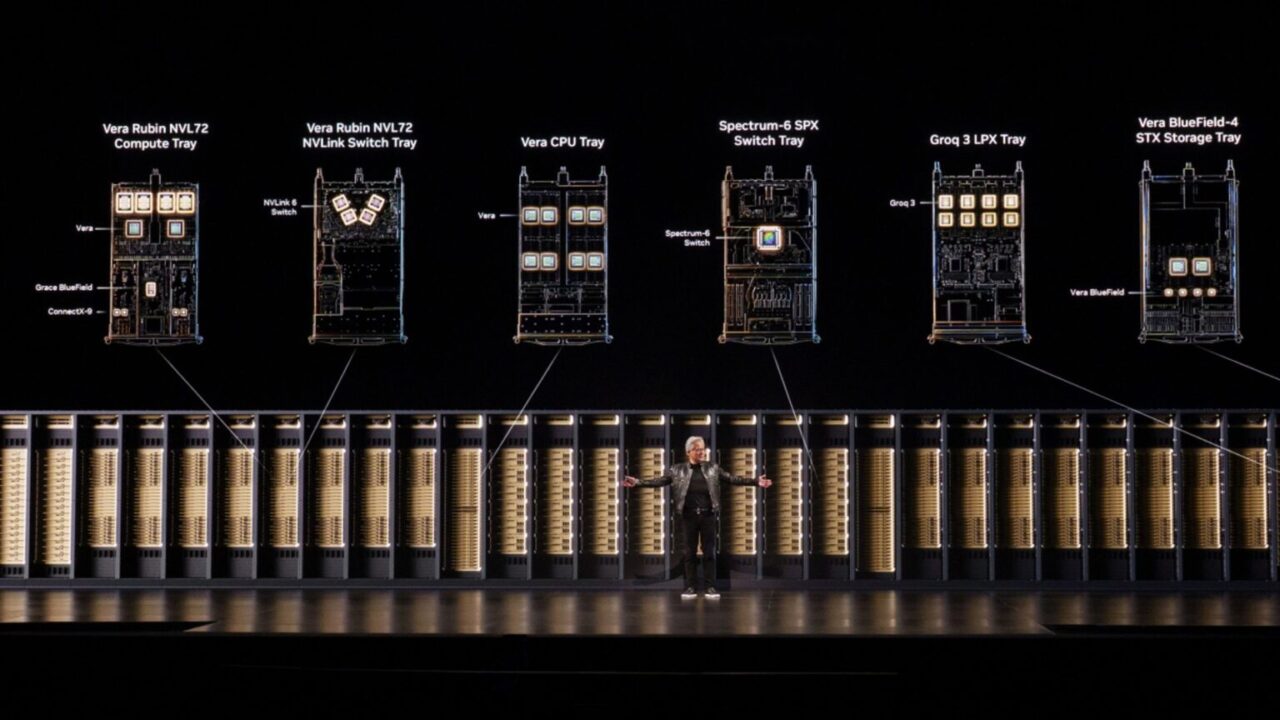
Les modèles plus grands, les contextes plus longs et les applications agentiques augmentent la pression sur la mémoire GPU, tandis que l’approvisionnement se réduit et que les prix augmentent, une tendance qui devrait se poursuivre à court terme.
NVIDIA travaille en étroite collaboration avec des partenaires de mémoire pour adopter rapidement les dernières technologies de mémoire. NVIDIA a été la première entreprise à adopter les technologies HBM3e et HBM4 dans une pile de calcul accéléré.
Mais l’approche ne consiste pas simplement à intégrer davantage de mémoire sur le GPU. C’est une co-conception Full-Stack. NVIDIA conçoit intentionnellement des GPU, des CPU, la mise en réseau, le stockage et les logiciels ensemble pour obtenir un travail plus utile de la mémoire à chaque couche de l’usine d’IA.
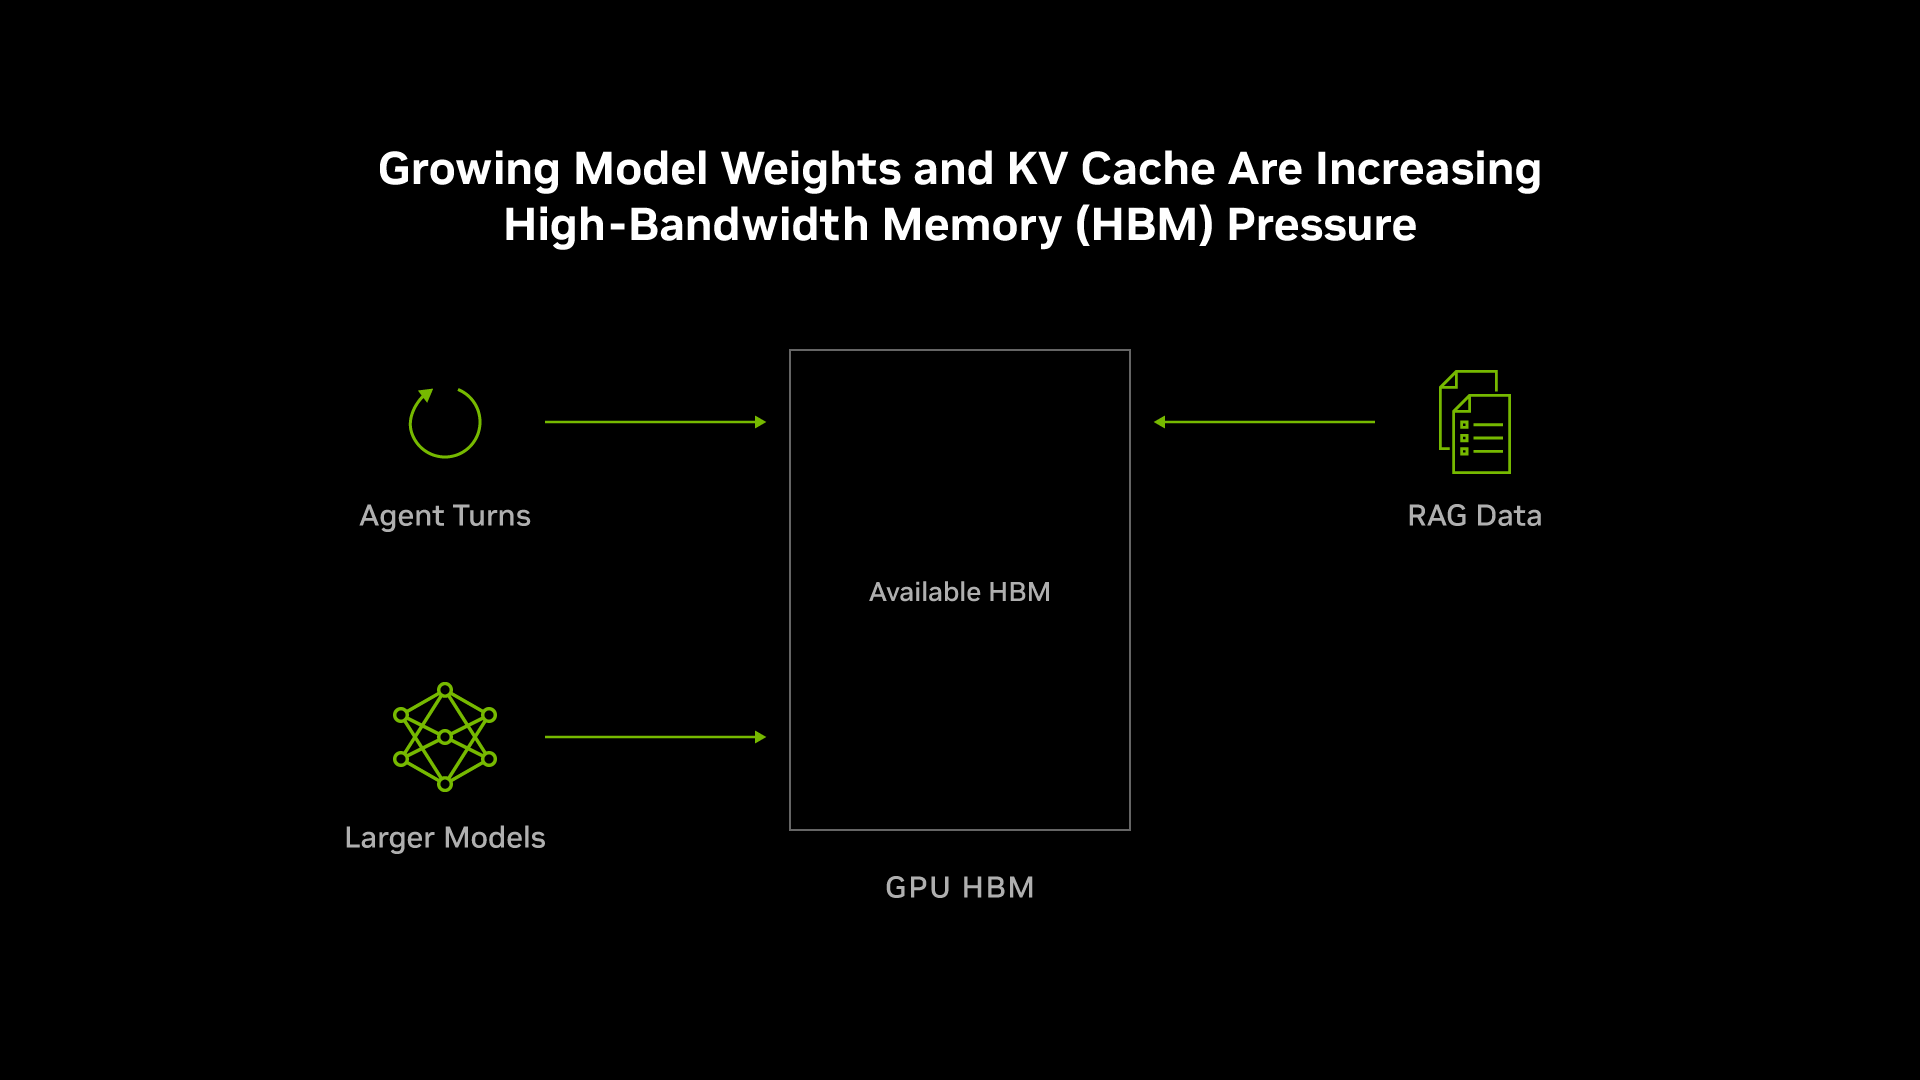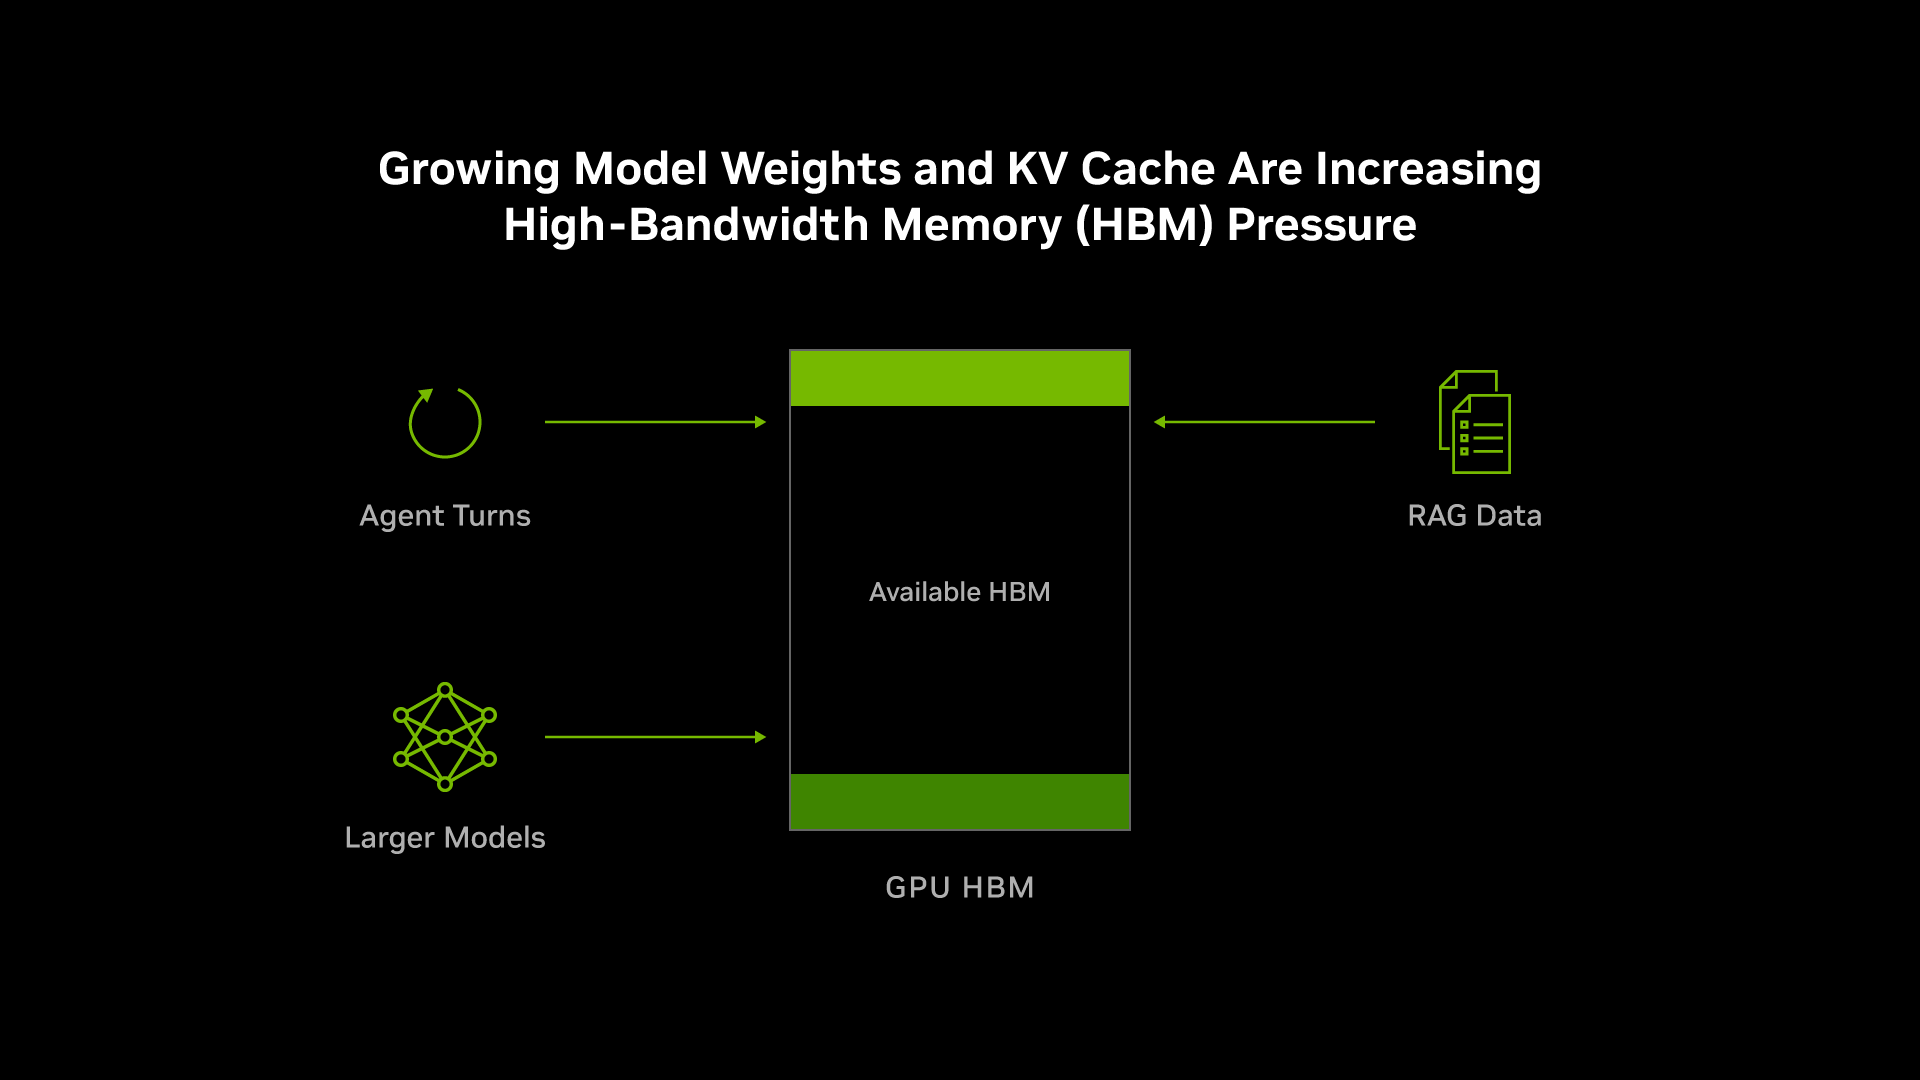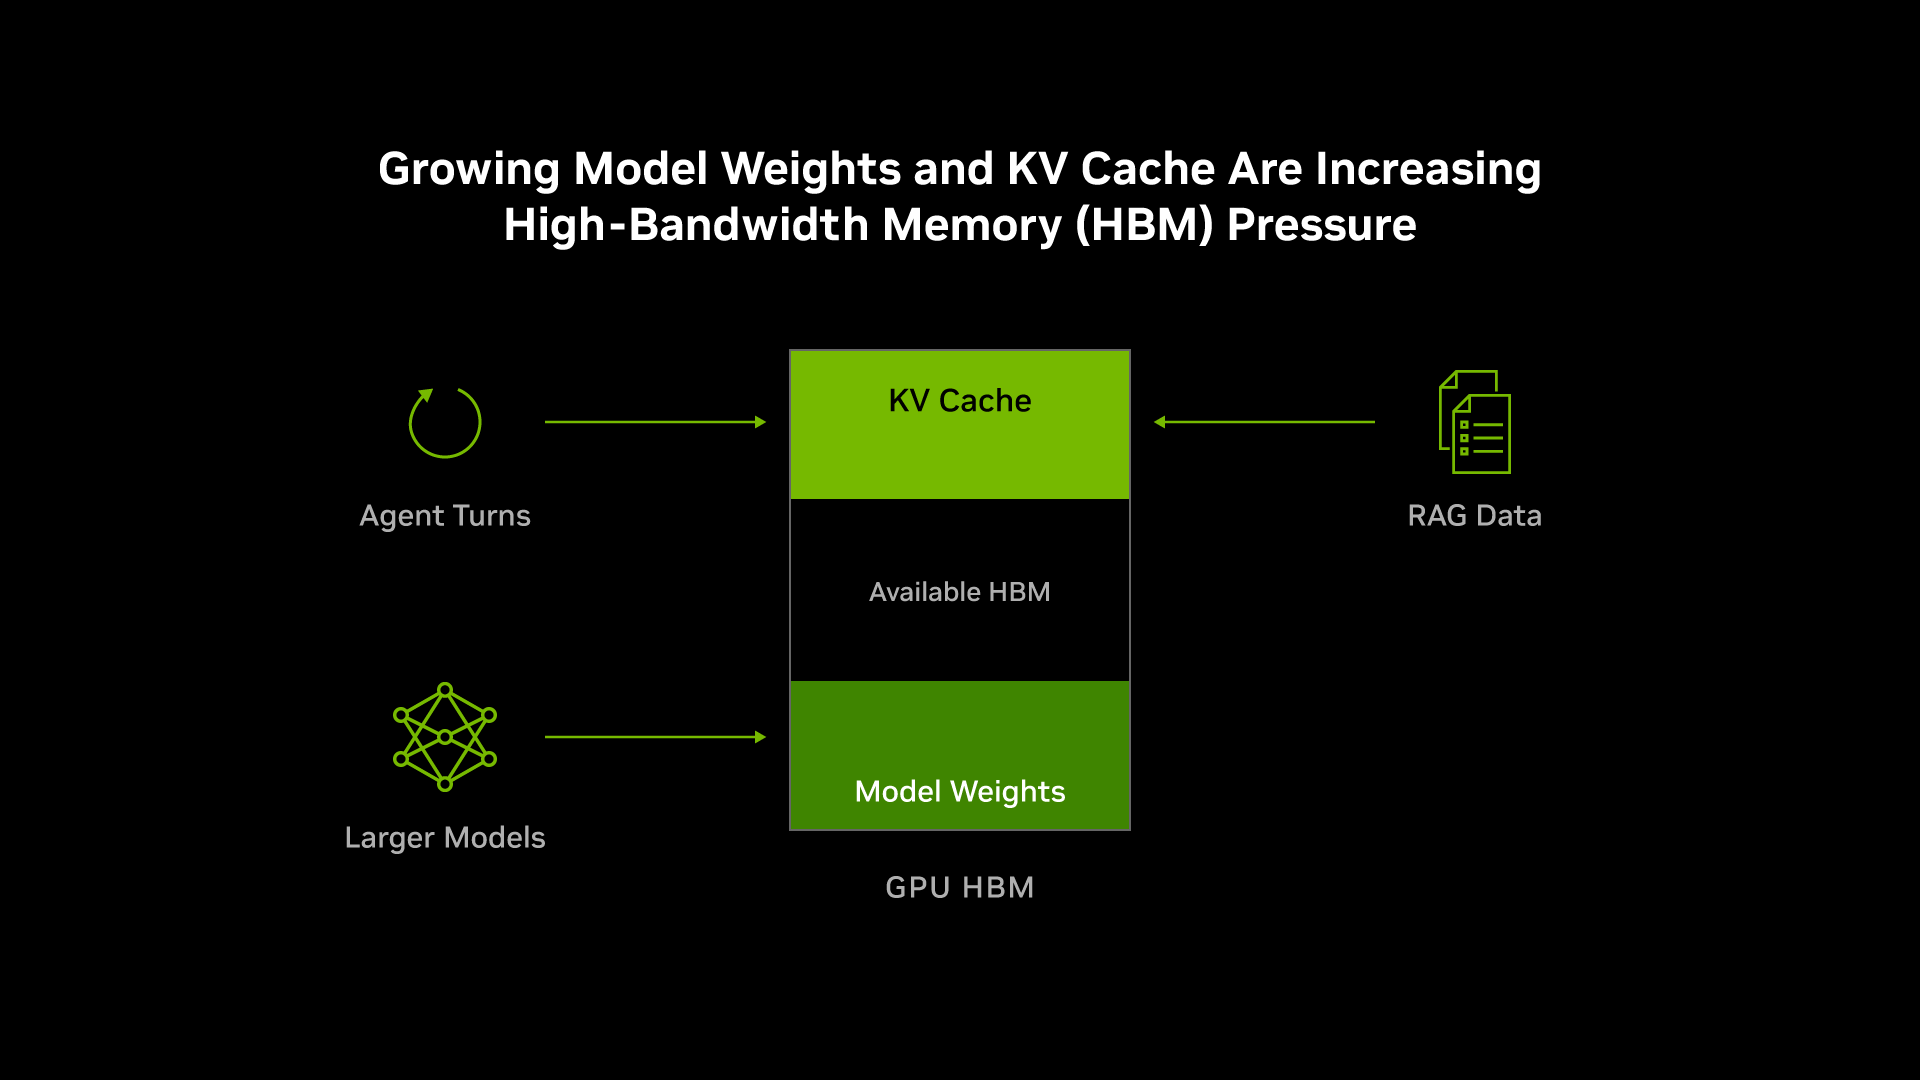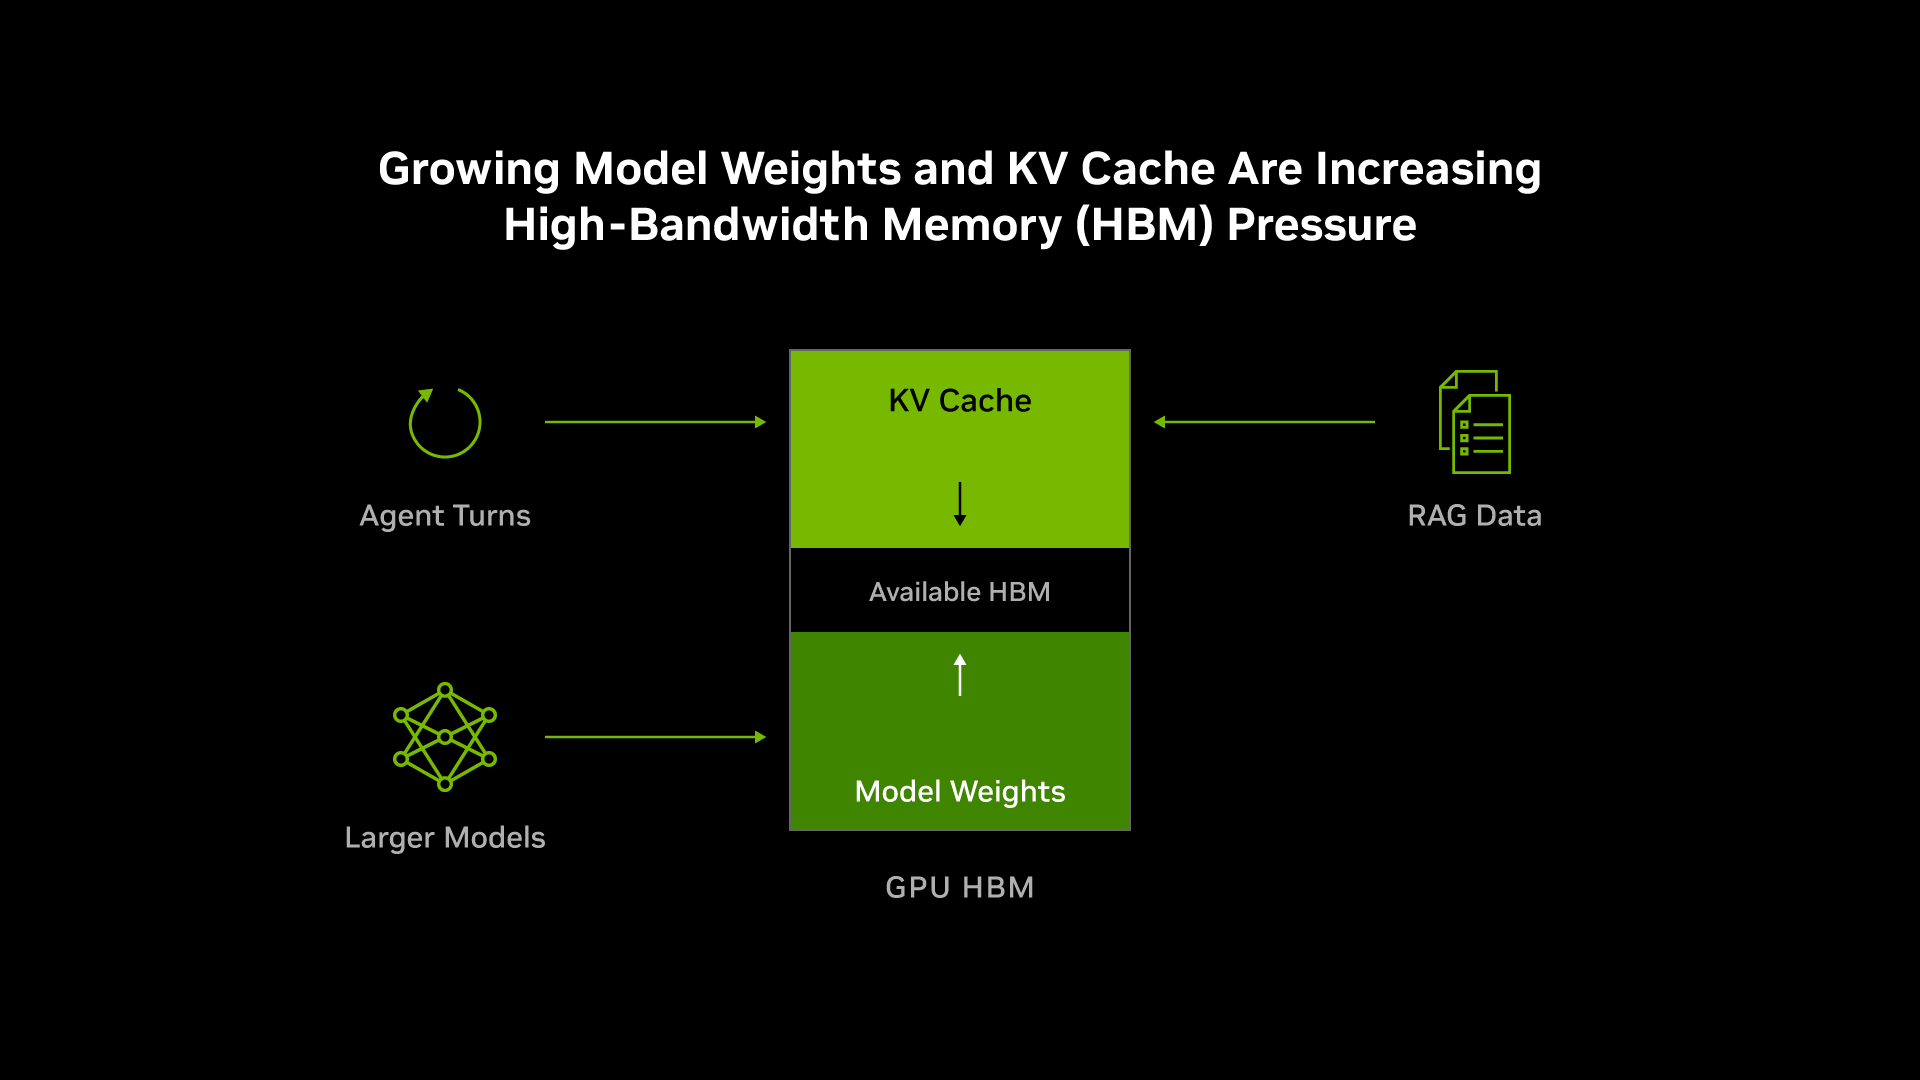
Cela est important, car une usine d’IA fonctionne sur une hiérarchie de la mémoire et du stockage. La mémoire GPU à bande passante élevée (HBM) est le niveau le plus rapide, le plus coûteux et le plus sollicité — avec des poids de modèle et un cache KV en concurrence pour une capacité limitée. Sous le CPU se trouvent la mémoire, les SSD locaux et le stockage partagé, chacun privilégiant la capacité au détriment de la vitesse, pour un coût par bit moindre.
L’efficacité d’un octet dépend de la manière dont l’ensemble de la hiérarchie est exploitée : réduire le volume des données à stocker, les placer sur le niveau approprié et les renvoyer vers le GPU avant qu’elles ne soient nécessaires.
Octet après octet, NVIDIA fait l’usage le plus efficace de la mémoire à chaque couche, et les résultats le prouvent. Du NVIDIA Blackwell Ultra à la plateforme Vera Rubin, la capacité HBM par GPU a augmenté d’environ 3 %, tandis que le débit agentique par dollar a été multiplié par 30 sur SemiAnalysis AgentX.
L’inférence agentique met davantage de pression sur la HBM
Les modèles de pointe disposent désormais de billions de paramètres, les valeurs qui conservent ce qu’un modèle d’IA a appris pendant l’entraînement.
Le cache KV, qui stocke le contexte dont le modèle a besoin pour comprendre chaque demande active sans retraiter les mêmes informations, est également en cours d’expansion. Les trajectoires agentiques conservent le contexte antérieur lors des appels répétés au modèle et à l’outil, traitant dans certains cas jusqu’à 3 millions de jetons, de sorte que la mémoire de travail de chaque requête s’accroît au fil du temps.
La génération augmentée par récupération (RAG) ajoute des informations d’entreprise pertinentes aux invites, créant ainsi encore plus de contexte à traiter et à conserver.
Pendant l’inférence, HBM stocke principalement les paramètres du modèle et le cache KV. Conséquence, une pression accrue sur la HBM.
Pourquoi les usines d’IA ont besoin d’une hiérarchie de mémoire
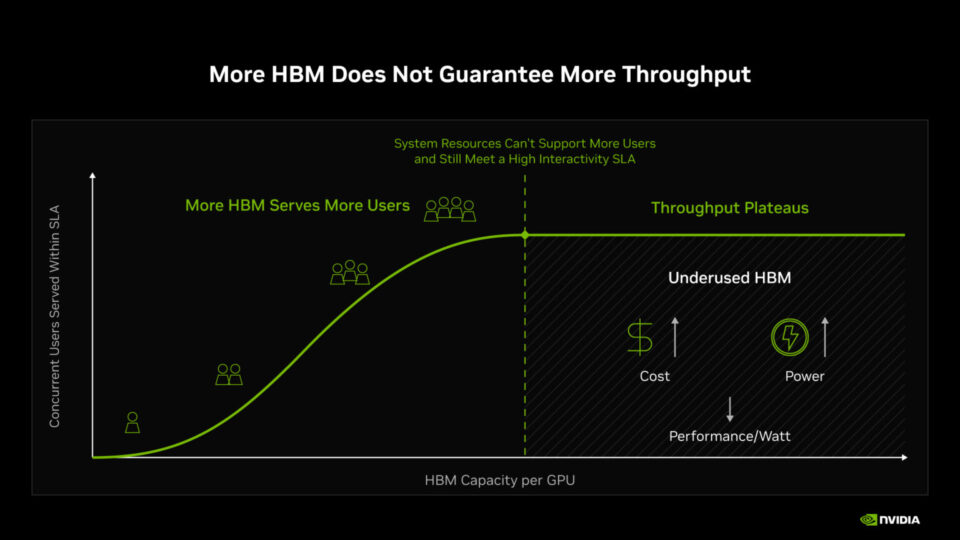
L’ajout de capacité HBM supplémentaire par GPU est la réponse évidente à cette pression, mais cette capacité permet uniquement de traiter ce que la bande passante est capable de transférer.
Pensez à HBM comme à un entrepôt et à une bande passante mémoire comme à ses quais de chargement. Un entrepôt plus grand peut contenir plus de stocks, mais les quais définissent la quantité de choses qui peut entrer et sortir en même temps. Une fois que les quais sont à pleine capacité, le transfert d’un stock supplémentaire prend plus de temps et ralentit les temps de réponse. Si les retards dépassent le niveau de service requis, l’espace supplémentaire ne peut pas être utilisé efficacement, même si cela augmente les coûts et consomme de l’énergie.
C’est également la raison pour laquelle aucune opération ne conserve l’ensemble de son inventaire dans l’espace le plus proche et le plus rapide. Ce qui est en mouvement reste à proximité de la ligne. Ce qui est en attente se déplace vers un espace plus grand et moins cher à proximité et revient avant que cela ne soit nécessaire.
Une usine d’IA est confrontée à la même limite.
Davantage de HBM peuvent contenir davantage de cache KV et prendre en charge davantage d’utilisateurs simultanés. Chaque utilisateur ajouté partage la même bande passante de calcul et la même bande passante mémoire. Mais lorsque chaque utilisateur s’attend à des réponses rapides, la bande passante mémoire finit par ne plus être en mesure de fournir les données aussi vite que le système de calcul peut les utiliser, c’est ce que les ingénieurs appellent le mur mémoire.
Passé ce point, il n’est pas possible de mettre en œuvre une capacité supplémentaire HBM, mais cela augmente les coûts et consomme de l’énergie. Les données ont toujours besoin d’un endroit où résider, mais toutes n’ont pas besoin du niveau le plus rapide et le plus coûteux. C’est pourquoi une usine d’IA gère les données dans une hiérarchie de mémoire et de stockage.
Maximiser la valeur de chaque octet grâce à la co-conception Full-Stack
La co-conception Full-Stack de NVIDIA fait en sorte que chaque octet de HBM compte en réduisant la pression liée aux poids des modèles, au cache KV et aux données RAG. Pour ce faire, elle utilise des techniques qui s’attaquent chacune à une source différente d’inefficacité :
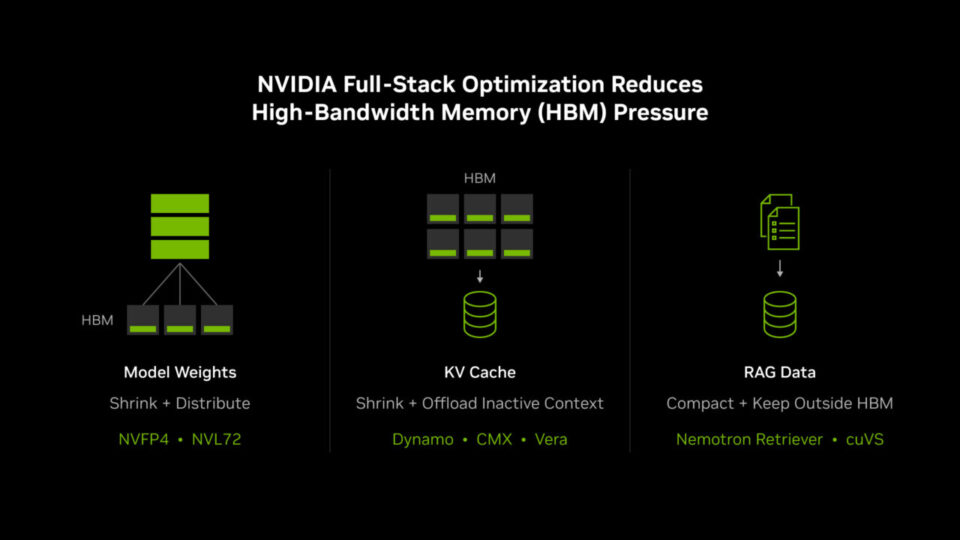
Réduisez les poids des modèles et distribuez-les sur l’ensemble du domaine NVL72.
- Le format NVFP4 réduit l’espace nécessaire pour les poids par rapport au FP8, qui est la précision la plus faible possible sur la plateforme NVIDIA Hopper. Des modèles récents, notamment FLUX.2 [klein] de Black Forest Labs, Inkling de Thinking Machines Lab, Beam 1.0 de Reflection, Meta Muse Spark de Meta, Step 5 Preview de StepFun et NVIDIA Nemotron 3.5 Super VL ont été déployés avec des points de contrôle NVFP4, ce qui témoigne de l’adoption croissante, par les développeurs de modèles, de la précision 4 bits pour une inférence plus rapide et plus économe en mémoire.
- Au sein d’un système NVL72, les poids des modèles peuvent être distribués sur jusqu’à 72 GPU, de sorte que chaque GPU gère une part plus petite du modèle, laissant ainsi plus de HBM pour le cache KV et les utilisateurs simultanés.
Réduisez le cache KV et transférez le contexte inactif vers des couches de stockage moins coûteuses.
- L’utilisation de NVFP4 dans le cache KV réduit son encombrement par rapport au FP8, ce qui permet de conserver davantage de contexte en mémoire HBM.
- Le CPU NVIDIA Vera y contribue de deux manières. Une exécution plus rapide des outils réduit la durée pendant laquelle le cache KV reste inactif lors des appels d’outils, et sa mémoire LPDDR volumineuse, connectée aux GPU NVIDIA Rubin via l’interconnexion NVIDIA NVLink-C2C, offre au contexte mis en pause un emplacement proche où attendre et reprendre rapidement.
- Lorsque le contexte n’est pas activement utilisé, le logiciel d’inférence NVIDIA Dynamo le déplace vers le stockage en mémoire contextuelle NVIDIA CMX, une couche conçue pour offrir une capacité à un coût par bit nettement inférieur à celui de la HBM, et le remet en service avant sa réutilisation. Contrairement aux disques SSD locaux, le CMX est partagé sur plusieurs serveurs et, contrairement au stockage d’entreprise, il évite les frais généraux liés à la protection des données à long terme dont un contexte à courte durée n’a pas besoin. Les partenaires de stockage de mémoire contextuelle NVIDIA CMX incluent Cloudian, DDN, Dell Technologies, Everpure (anciennement Pure Storage), HPE, IBM, NetApp, VAST et WEKA.
- La solution KV Cache Reuse de Dynamo relie les différents niveaux entre eux, en gérant le cache KV comme une ressource unique à l’échelle du système, couvrant à la fois la mémoire du GPU, celle du CPU et le stockage. Ainsi, le contexte calculé une seule fois peut être réutilisé dans l’ensemble du système.
Intégrations RAG compactes et maintien de l’IndeX en dehors de la HBM.
- RAG transforme les documents d’entreprise en représentations vectorielles, c’est-à-dire en représentations numériques qui permettent à un système d’effectuer des recherches en fonction du sens plutôt que par mot-clé, organisées en un index consultable. Les modèles NVIDIA Nemotron Retriever produisent des intégrations plus petites avec une précision de récupération plus élevée, tandis que la bibliothèque NVIDIA cuVS permet de créer et de gérer cet IndeX sur les CPU et le stockage. La base de connaissances n’occupe jamais la HBM, et seuls les passages dont le modèle a besoin entrent en contexte.
Il en résulte une réduction de la quantité de mémoire HBM utilisée pour les poids des modèles, une diminution de la mémoire HBM immobilisée par des contextes inactifs et une augmentation de la mémoire disponible pour servir les utilisateurs simultanés.
Résultat plus utile par dollar à chaque génération
Au fil des générations successives de plateformes NVIDIA, le nombre de jetons par seconde et par dollar a augmenté bien plus rapidement que la capacité HBM.
Sur la charge de travail SemiAnalysis AgentX DeepSeek V4 Pro, le NVIDIA GB300 NVL72 fournit un débit par dollar jusqu’à 10 fois plus élevé que la plateforme NVIDIA H200, à 100 jetons par seconde par utilisateur, la capacité HBM par GPU doublant à peu près. À raison de 125 jetons par seconde et par utilisateur, le Vera Rubin NVL72 offre un débit par dollar jusqu’à 30 fois supérieur à celui du GB300 NVL72, avec une capacité HBM par GPU en hausse d’environ 3 %.
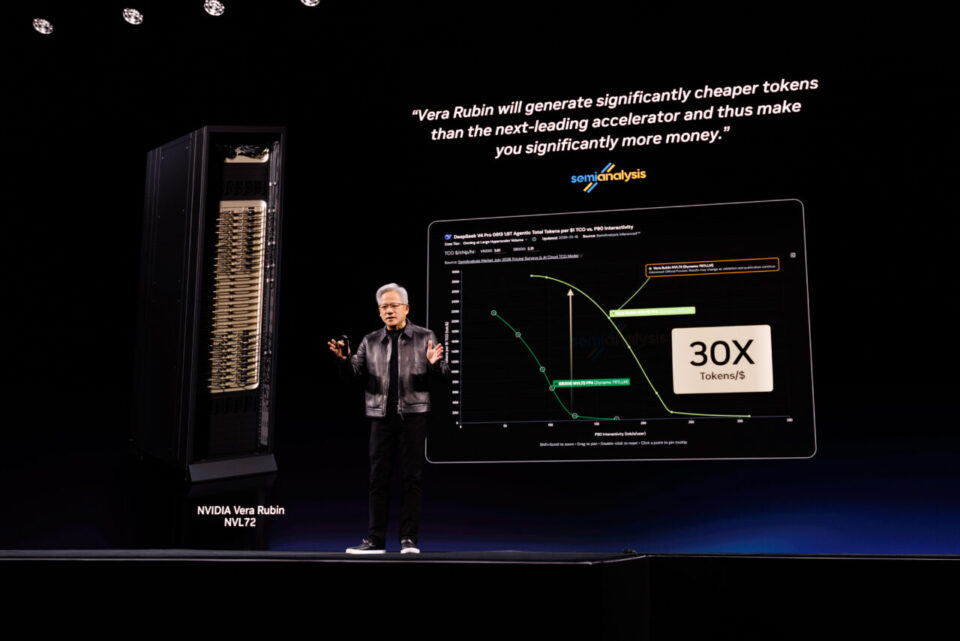
Pour les opérateurs des usines d’IA, la métrique qui compte est le nombre de jetons utiles que l’usine peut fournir dans les limites de son budget énergétique tout en répondant aux besoins des utilisateurs en matière de temps de réponse. Un nombre plus élevé de jetons par seconde par watt signifie plus de travail et de revenus pour la même énergie, ainsi qu’un coût plus faible pour chaque jeton. La co-conception Full-Stack de NVIDIA réduit les coûts des jetons en augmentant le travail utile fourni par chaque octet de mémoire.
Découvrez dans la vidéo explicative et l’analyse technique approfondie comment la co-conception Full-Stack de NVIDIA réduit la pression sur la mémoire d’inférence.